인프라/Kubernetes
[쿠버네티스] Longhorn 정리
Hun's blog
2026. 7. 5. 15:33
Longhorn 개요
- LongHorn은 가볍고, 신뢰성 있고, 쉽게 사용할 수 있는 쿠버네티스 기반 분석 블럭 스토리지이다.
- Rancher Labs 라는 회사에서 만들어 졌으나 현재는 CNCF에 기증되어 incubating 프로젝트이다.
무엇을 할 수 있는가?
- 여러 노드의 로컬 디스크를 하나의 풀로 관리하며, 데이터를 여러 노드에 복제할 수 있다.
- 노드에 데이터가 replica 되어 노드로 인한 단일 실패 지점을 해소 (고가용성)
- NFS 혹은 S3를 통해 데이터를 백업할 수 있다.
언제 도입하면 좋은가?
- 스토리지 관련 리소스가 없을 때 (클라우드, SAN 포함)
- 온프레미스 환경에서 중소규모로 스토리지 환경이 필요할 때
- 동일한 데이터의 다중 접근이 드문 상황일 때 (다중 접근을 위해 블록 스토리지 위에 NFS 레이어를 얹기 때문에 성능 저하 발생)
- 간편하고 신속한 백업 및 재해 복구가 필요할때 (간편하게 nfs 혹은 s3 저장소에 볼륨 백업 가능)
- 쿠버네티스 네이티브한 스토리지 관리를 원할 때 (쿠버네티스의 동적 프로비저닝을 통해 볼륨 생성 및 사용 가능)
- Local PVC 를 사용하자니 노드 장애로 인한 데이터 유실 및 가용성 저하가 우려될 때
Local PVC vs Longhorn 장단점 비교
Longhorn의 장점
- 노드 장애 시 데이터 자동 복구: Local PVC는 해당 노드가 죽으면 파드가 다른 노드로 이동해도 데이터에 접근할 수 없음
- 자유로운 파드 스케줄링: Local PVC는 특정 파드에 종속되지만, Longhorn은 어느 노드에서나 자유롭게 띄우고 이동가능
- 편리한 운영 기능 기본 제공: 볼륨 크기 자동 확장, 스냅샷 생성, 외부 저장소 백업 등 기능 제공
Longhorn의 단점
- I/O 성능저하: Longhorn 은 데이터 쓰기 동작 시 모든 레플리카에게 동기적으로 적용함으로 I/O 성능이 Local PVC 보다 저하됨
- 추가 리소스 소모: 분산 스토리지 유지를 위한 CPU, 메모리를 일정 부분 소모
아키텍처와 컨셉
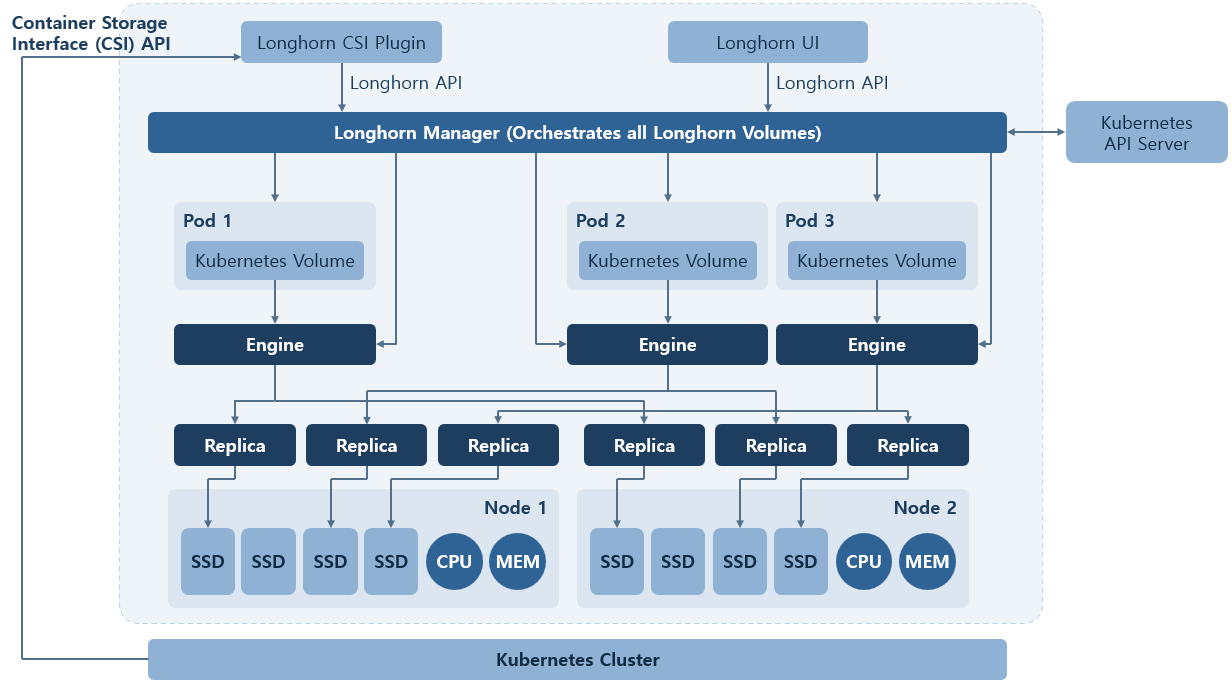
Longhorn은 크게 data plane과 control plane으로 나눌 수 있는데, Longhorn Engine이 data plane에 해당하고 Longhorn Manager가 control plane에 해당한다.
Longhorn CSI Plugin
- 쿠버네티스의 동적 프로비저닝 기능을 Longhorn과 연동 시켜주는 플러그인이다.
- 사용자가 storageClassName: longhorn 으로 PVC를 만들면 longhorn 과 연동시킨다.
Longhorn Manager
- 모든 노드에 하나씩 상주하며 Longhorn 클러스터 전체를 제어하는 데몬셋이다.
- CSI Plugin 혹은 UI에 의한 요청에 맞춰 Longhorn ㅂ로륨 리소스 생성을 지시한다.
- 볼륨 생성이 확정되면 Engine(컨트롤러)과 Replica(복제본)을 띄우도록 지시한다.
- 사용자가 접속하는 Longhorn UI 나 쿠버네티스의 CSI 플러그인이 보내는 명령을 가장 앞단에서 받아 처리한다.
Longhorn Engine
- 볼륨 1개 만을 전담 관리하는 스토리지 컨트롤러이다.
- 애플리케이션 파드에 있는 노드에 가상의 블록 디바이스를 만들어 노출하여 kubelet 이 애플리케이션 파드와 바인드 마운트 해준다.
- 애플리케이션에 의해 볼륨에 쓰기(Write) 동작이 발생하면 Replica들에게 동기적으로 복제한다.
- 특정 노드의 Replica에 장애가 발생해도 다른 노드의 정상 Replica를 통해 애플리케이션에 중단 없이 고가용성을 제공한다.
Longhorn Replica
- 볼륨의 데이터를 노드의 물리적 디스크에 저장한다.
- Longhorn Engine 에게 물리적인 데이터를 제공한다.
- 데이터 고가용성을 위해 설정된 복제본 개수(예: 3개)만큼 여러 노드에 분산되어 생성된다.