Loki 개요
- Loki는 수평 확장 가능한, 고가용성, 멀티 테넌트 로그 집계 시스템이다.
- 보통 Promtail이나 Grafana Alloy와 같은 수집기를 통해 로그를 Loki에 저장하고, Grafana에서 쿼리하여 시각화한다.
- Loki는 로그 내용을 인덱싱하는 대신 라벨만 인덱싱함으로써, 효율적이고 운영이 쉬운 로그 플랫폼을 제공한다.
무엇을 할 수 있는가?
- 여러 에이전트(Promtail, Grafana Alloy)를 통해 여러 서버, 클러스터에서 나오는 로그를 하나의 Loki로 모을 수 있다.
- app, env, cluster, namespace 와 같은 라벨을 기준으로 특정 서비스, 환경, 클러스터의 로그만 빠르게 필터링할 수 있다.
- Loki를 Grafana 데이터 소스로 붙이고 시간 단위로 쿼리해 로그를 조회할 수 있다.특정 조건(에러 등)을 만족하면 Aletermanager/Grafana Aletering 으로 알림을 받을 수 있다.
언제 도입하면 좋은가?
- K8s 클러스터에서 로그가 노드별로 흩어져 있어, 장애 발생 시 각 서버에 접속해 로그를 찾아야 하는 환경일 때
- K8s Pod가 재시작·스케일링을 자주하여, 특정 Pod의 로그를 한 번에 모아 보기가 어려울 때
- K8s Pod 복제수를 2 이상으로 설정하여 로그가 여러 노드에 분산되어 있는 환경일 때
- 기존 ELK 사용 시 저장 비용이나 운영 복잡도 측면에서 부담을 느낄 때
아키텍처와 컨셉
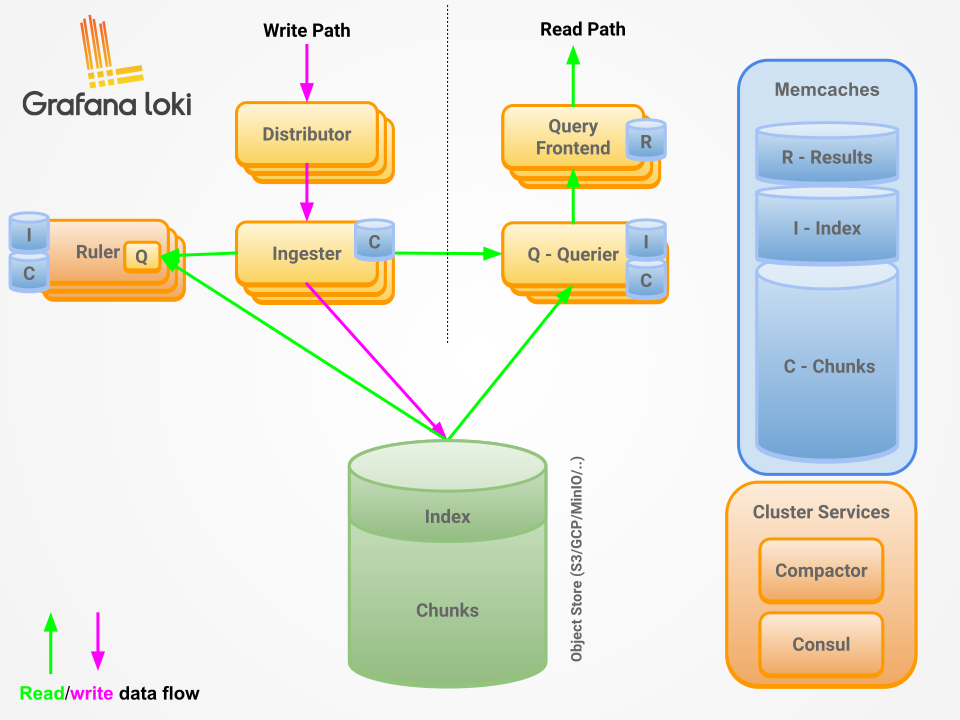
Distributer
클라이언트(에이전트)로부터 들어오는 모든 로그 push 요청을 담당하는 쓰기 경로(write path)의 첫 엔드포인트이다. 요청 받은 스트림을 검증하고 전처리한 뒤, 일관 해싱 (consistent hashing)으로 대상 Ingester를 선택하여 복제 계수(replication factor)만큼 병렬 전송한다.
Distributor의 처리 흐름은 수신 -> 검증 -> 전처리 -> 처리율 제한 -> 대상 Ingester 선택 및 전달 -> 병렬 전달 -> 정족수 응답 확인 이 있다. 자세한 사항은 공식 문서를 참고하기를 바란다. 공식 문서
Ingester
Ingester 서비스는 쓰기 경로(write path)에서는 로그 데이터를 메모리에 청크 단위로 적재하고, 압축하여 S3, GC3 등 장기 스토리지로 전송하는 역할을 한다. 동시에 읽기 경로(read path)에서는 최근에 적재된, 아직 플러시되지 않은 인메모리 로그데이터를 쿼리에 응답하기 위해 사용된다.
Query frontend
Query frontend는 Loki의 읽기 경로(read path)를 가속하기 위해 사용하는 선택적(optional) 컴포넌트로, Querier 앞단에서 쿼리 요청을 받아 분산 처리하기 쉽게 만들어준다. 내부적으로는 쿼리를 큐에 적재하고, 필요한 경우 여러 구간으로 분할한 뒤, Querier가 이를 병렬로 처리할 수 있도록 중개한다.
Querier
Querier 서비스는 Loki에서 LogQL(Log Query Language) 쿼리를 실제로 실행하는 컴포넌트로, 읽기 경로(read path)의 핵심에 해당한다. Querier는 구성 방식에 따라 클라이언트의 HTTP 요청을 직접 받아 처리하거나, Query frontend/Query scheduler로부터 전달된 서브쿼리를 워커(worker)처럼 실행한 뒤 결과를 반환한다.
실행 모드
Monolithic (SingleBinary)
- Distributor, Ingester, Querier 등 Loki 컴포넌트를 하나의 프로세스/Pod로 실행하는 방식이다.
- 설정과 운영이 가장 단순하다. 개발 환경이나 로그량이 많지 않은 사내 클러스터에 적합하다.
- Pod 하나에 장애가 나면 Loki 전체가 영향을 받으므로 고가용성 구성에는 맞지 않는다. 이 문서의 Helm 설치 예시는 이 방식을 기준으로 한다.
SSD (Simple Scalable Deployment)
- 컴포넌트를 `read`, `write`, `backend` 세 영역으로 나눠 배포하는 방식이다.
- 쓰기량이 많으면 `write`를, 조회 요청이 많으면 `read`를 각각 늘릴 수 있어 Monolithic보다 확장하기 쉽다.
- 데이터를 오브젝트 스토리지에 저장하는 구성을 전제로 하며, 운영 환경에서 가장 먼저 고려할 만한 배포 방식이다.
- 다만 저장소 설정과 운영할 Pod 수가 늘어나므로, 작은 환경에서는 Monolithic이 더 편할 수 있다.
'인프라 > Kubernetes' 카테고리의 다른 글
| [쿠버네티스] Nginx Gateway Fabric 정리 및 설치 (0) | 2026.09.02 |
|---|---|
| [쿠버네티스] MetalLB 정리 및 설치 방법 (0) | 2026.08.31 |
| [쿠버네티스] Longhorn 정리 (0) | 2026.07.05 |